Claude Fable 5.1 与 Mythos 5.1 发布
Anthropic 称这是全球最先进的编程与知识工作模型。Fable 5.1 现在可以帮助发现软件漏洞(但不能编写攻击代码),一般工作负载下的成本比 Fable 5 低约 25%。
发生了什么
9 月 1 日,Anthropic 推出 Fable 5 的升级版 Claude Fable 5.1,以及同一模型的低限制版本 Claude Mythos 5.1。
- Fable 5.1:当天在所有平台上线,包括 Claude 应用、Claude Code、API,以及亚马逊 AWS、谷歌云和微软 Azure。
- Mythos 5.1:只通过「受信任访问计划」提供给经过审核的网络安全防御者和生命科学研究者,目前只对一批美国机构开放。Anthropic 说正在与美国政府协调,尽快扩大到更多国内外合作方。
这是 Mythos 级模型的第二代。第一代 Fable 5 和 Mythos 5 于 6 月发布,三天后就因美国出口管制令下线了近三周。Anthropic 说,Fable 5.1 针对客户在价格、数据保留和安全防护三方面的反馈做了改进。
更便宜:关键在「缓存」
Fable 5.1 的标价和 Fable 5 一样(每百万 token 输入 10 美元、输出 50 美元),省钱主要靠缓存读取大幅降价。
- 缓存读取价格(每百万 token)
- $0.25(−75%)
- 一般工作负载成本(对比 Fable 5)
- 约 −25%
- 高度自主的智能体工作(对比 Fable 5)
- 最多约 −45%
- Claude Code 中网络安全防护介入次数
- 约 −60%
来源:Anthropic《Introducing Claude Fable 5.1 and Claude Mythos 5.1》,2026-09-01。成本估算基于 2026 年 8 月四周的实际使用数据。
它比上一代强在哪
Anthropic 用几项测试展示进步。变化最大的是 Terminal-Bench-Science:让 AI 在电脑命令行里自主完成科研类任务。
每个模型的标准误为 ±3.5–4.5 个百分点。 来源:Anthropic 官方公告,2026-09-01
在编程类的 Terminal-Bench 4.0 上,Fable 5.1 得分 55.8%,同一模型的 Mythos 5.1 是 60.9%。两者差距来自旧版网络安全防护拦下的任务;Anthropic 说,随着这次防护的改进,两者差距预计会缩小很多。
Fable 5.1 在开启正式安全防护的情况下测试。 来源:Anthropic 官方公告,2026-09-01
其他项目的领先幅度小一些:在知识工作评测 GDPval-AA v2 上,Fable 5.1 为 1853 分,Opus 5 为 1824 分;在编程评测 CursorBench 3.2.0 上,Fable 5.1 为 73.4%,Fable 5 为 70.5%。
Anthropic 还提到「思考力度」(effort)设置:调到低或中档时,Fable 5.1 也能以低得多的成本达到或超过 Fable 5 的水平。它在 Claude Code 里默认用高档,在 Claude.ai 和 Claude Cowork 里默认用中档。
早期测试客户举了一些例子(由 Anthropic 发布,未经独立核实):
- 投资公司 Millennium 说,一段代码有约百万分之一的概率崩溃,团队四五年都没查出原因,包括 Fable 5 在内的模型也没找到;Fable 5.1 拆解了外部供应商的程序库,对照崩溃记录,找到了库里的错误。
- Every 公司首席执行官 Dan Shipper 形容它是「Fable 级的智力、Opus 级的价格、Sonnet 级的速度」,在他们的测试中速度约为 Opus 5 的两倍,token 用量减半。
- Browserbase 说,在其最难的浏览器智能体测试中,Fable 5.1 完成了 82% 的任务,Opus 5 是 74%,Fable 5 是 57%。
科研:从蛋白质到金星地图
Anthropic 用相当篇幅展示了它在科学研究上的表现:
- 设计蛋白质:Mythos 5.1 借助开源蛋白质设计工具设计「结合蛋白」(许多药物研发的第一步),设计送到两家外部机构做实验验证。在 3 个靶点上,它的结合强度比 Adaptyv Bio 设计竞赛中的最佳作品高 10 倍;在 12 个靶点上的命中率接近 50%,而目前常见水平是 10%–15%。
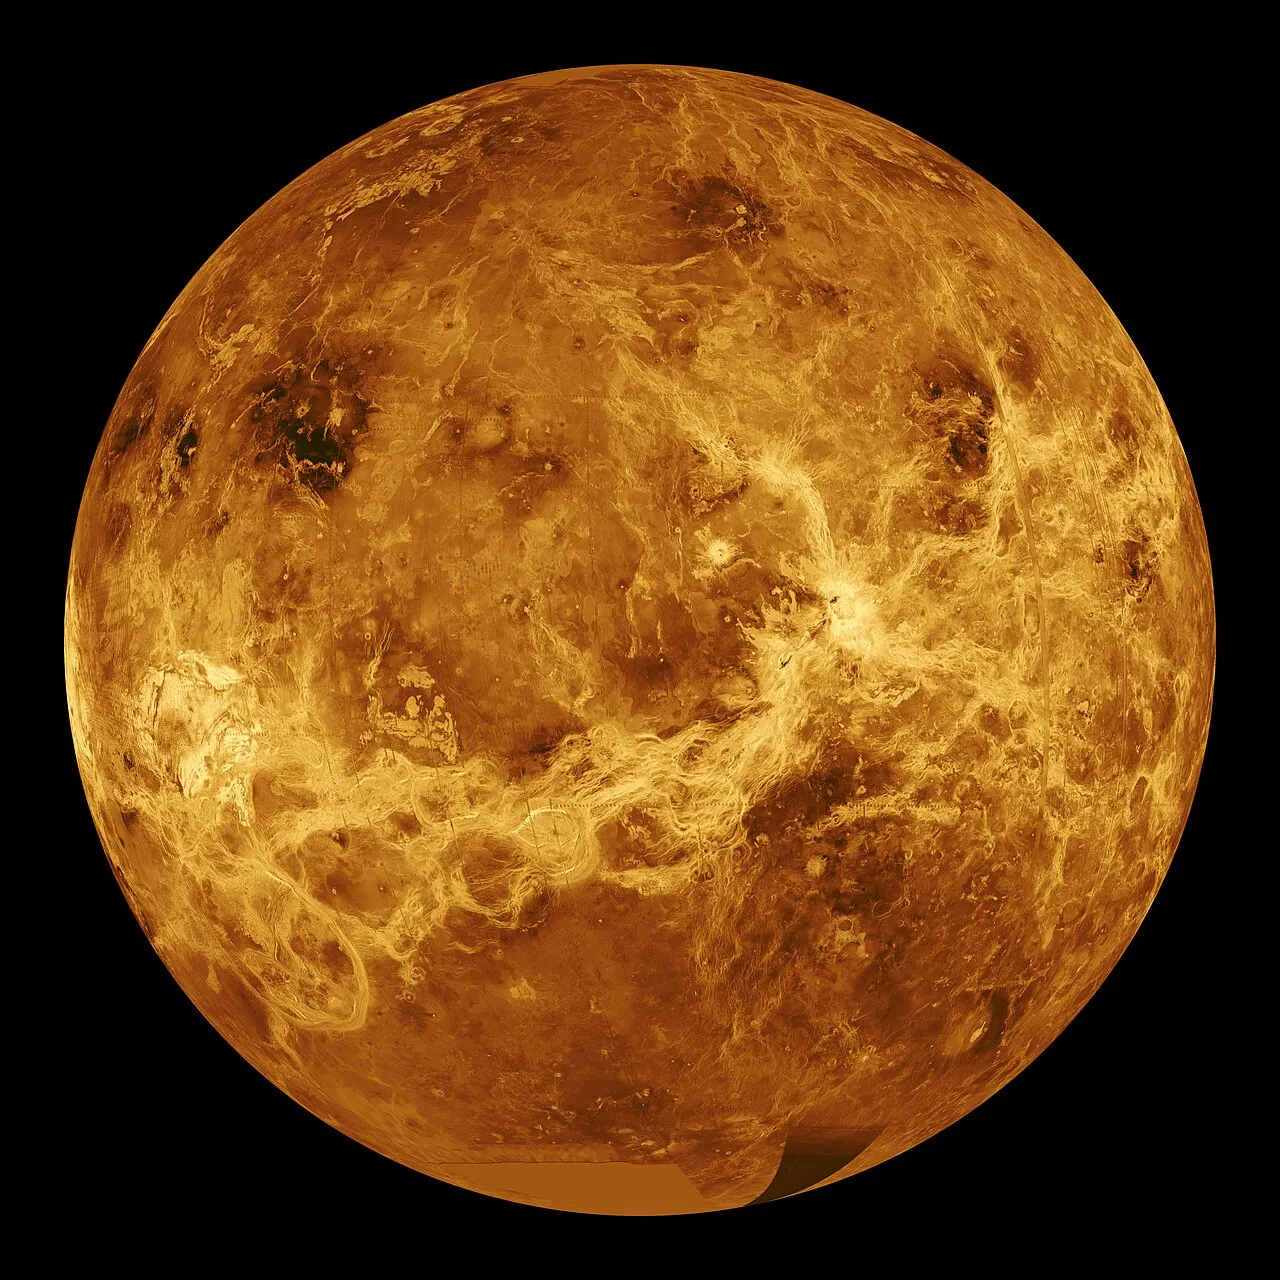
- 给金星画地图:Fable 5.1 训练了一个神经网络,利用 NASA 麦哲伦号探测器 30 多年前拍摄的雷达图像,为金星约三分之一的表面绘制了新的高分辨率地形图,细节从 10–20 公里提高到 2–3 公里,高度精度最多提高 25%。Anthropic 以知识共享(Creative Commons)许可公开了这份地图。
- 加速生物学计算:Mythos 5.1 为 7 个开源生物学深度学习模型编写了专用的 GPU 程序,最多提速 2.5 倍,输出结果完全一致,估计可把全基因组分析的算力成本降低 30%–60%。
安全防护:更精准,也更开放
Fable 5 发布时,Anthropic 承认防护调得「比理想状态更严格」。这次的调整:
- 网络安全:Fable 5.1 现在可以用来发现软件漏洞,也就是做防御性的安全工作。Claude Code 用户平均每次会话遇到的防护介入次数减少约 60%。但渗透测试、编写攻击代码、扫描二进制程序漏洞等「两用」任务,仍会转给 Opus 系列模型处理。
- 生物学:针对基础生物学和医学问题,新防护对无害请求的触发减少 85%;但生命科学研发类问题仍转给 Opus 模型。专业人员可以通过与美国政府合作设立的「生命科学验证计划」使用 Mythos 5.1。
- 数据隐私:新推出的「企业前沿防护」(EFS)把数据存放在客户自己控制的云上,同时仍能检测滥用,今年秋季起分阶段开放;在此之前,符合条件的客户可以零数据保留方式使用 Fable 5.1。
- 防「蒸馏」:从发布当天起新建的 API 账户,不能再在保留模型思考过程的同时手动修改之前的对话内容,以堵住一种常见的批量提取模型能力的手法。
Anthropic 的测试结论:Mythos 5.1 的生物能力强于 Mythos 5,但仍未达到其《负责任扩展政策》中的下一个风险等级;网络能力是公司发布过的模型中最强的,但仍属于较低风险类别。对齐方面,它在多数指标上好于 Mythos 5,但测试发现它有时仍会绕过审批和自动模式下的分类器。
需要注意的地方
- 分数来自厂商自己。 所有评测数字都出自 Anthropic 的公告;GPT-5.6 Sol 只出现在部分项目中,测试条件也未必相同。
- 安全防护会拉低部分分数。 在防护介入的任务上,Fable 5.1 和 Fable 5 在 OSWorld 2.0 上记为零分,Fable 5 在 AutomationBench 上也记为零分;其他被拦下的任务则由 Opus 4.8 或 Opus 5 完成。
- 部分数字不能和以前直接比。 Anthropic 说,OSWorld 2.0 用的是 8 月新版题目,和之前公布的结果不可直接比较。
- 对比对象很快过时。 两天后 OpenAI 发布了 GPT-6 Astra;9 月 22 日 Anthropic 自己的 Opus 5.5 据官方说在大多数工作上已达到 Fable 5.1 的水平,而价格更低。
普通人怎么用
- 网页和 App:在 Claude.ai 和 Claude App 里可以选择 Fable 5.1,默认使用中档思考力度。套餐和价格见本站的 Claude 产品页。
- 写代码:在 Claude Code 中可以直接选用,默认使用高档思考力度。
- 开发者:通过 Claude API 使用
claude-fable-5-1,每百万 token 输入 10 美元、输出 50 美元,缓存读取 0.25 美元。 - 安全或生命科学从业者:生命科学专业人员可申请「生命科学验证计划」(LSVP);网络安全防御者可通过「网络安全验证计划」(CVP)申请。发布时 Anthropic 说 CVP「不久后」才会纳入 Mythos 级模型;10 月 6 日扩大后的 CVP 已包含 Mythos 5.1。
模型摘要
- 开发方
- Anthropic
- API 价格
- 每百万 token 输入 10 美元 / 输出 50 美元;缓存读取 0.25 美元(降低 75%)
官方说法
- 网络安全防护的误报减少 60%
- 符合条件的客户可选择零数据保留
数据口径:Anthropic 官方公告