DeepSeek 发布开源推理模型 R1
DeepSeek 发布 R1 及蒸馏推理模型的公开权重。官方评测报告了较强的数学和推理表现,为研究与部署增加了选择。
发生了什么
2025 年 1 月 20 日,DeepSeek 发布了 DeepSeek-R1。官方发布说明用几句话概括:性能与 OpenAI-o1 相当;模型和技术报告完全开源;代码和模型采用 MIT 许可证,「可以自由蒸馏和商用」;网页版和 API 当天上线,在 chat.deepseek.com 打开「深度思考」(DeepThink)按钮即可使用。
同时公开的还有两样东西:
- R1-Zero:一个只靠「强化学习」训练出来的实验版本(下文解释);
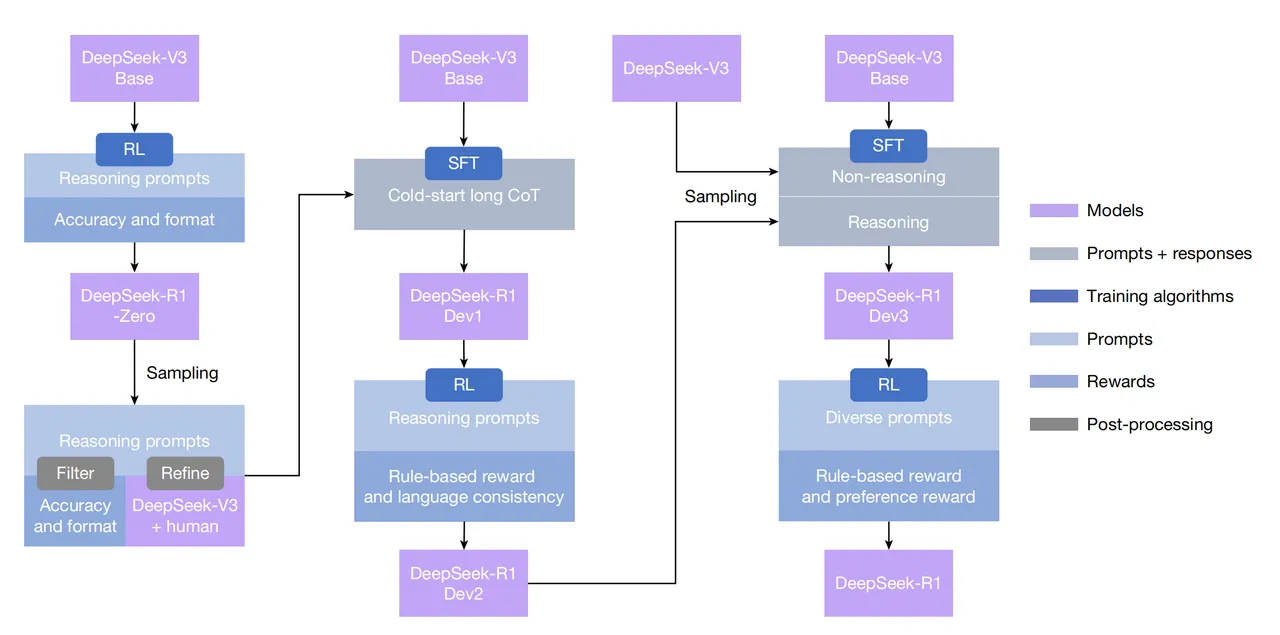
- 六个「蒸馏」小模型:DeepSeek 用 R1 生成的约 80 万条样本,去训练阿里的 Qwen2.5 和 Meta 的 Llama 3 系列开源模型,参数规模从 15 亿到 700 亿不等。DeepSeek 称其中 320 亿和 700 亿参数的版本与 OpenAI 的 o1-mini 水平相当。
R1 本身的规模是:总参数 6710 亿,但每次回答只启用其中约 370 亿(这种设计叫「混合专家」,可以理解为模型里有很多「专家」,每次只叫醒相关的一部分,省算力)。它是在 DeepSeek 一个月前发布的 V3 基础模型上训练出来的。
背景:什么是「推理模型」
R1 属于「推理模型」:回答之前会先写出一长段思考过程(可以看到它「想」了什么),再给出答案。这类模型擅长数学、编程这类需要一步步推导的问题。OpenAI 在 2024 年 9 月发布的 o1 是这类模型的代表。
R1 的意义之一,是把一种训练方法完整公开了。DeepSeek 在论文中说,R1-Zero 是「第一个公开研究验证」:大模型的推理能力可以纯粹通过强化学习激发出来,不需要先用人工示范数据做「监督微调」。
它有多强
DeepSeek 在模型说明中把 R1 和 OpenAI o1(2024 年 12 月 17 日版本)等模型放在一起比较。最常被引用的是美国数学邀请赛 AIME 2024:这是给美国高中数学尖子生出的竞赛题,难度远高于普通考试。
所有分数均由 DeepSeek 在模型说明中公布;o1 为 2024-12-17 版本。 来源:DeepSeek-R1 模型说明(Hugging Face),2025-01-20
在同一张表里,R1 并不是全面领先:
| 评测 | 测的是什么 | R1 | o1 |
|---|---|---|---|
| MATH-500 | 数学题 | 97.3% | 96.4% |
| Codeforces | 编程竞赛(超过多少比例的人类选手) | 96.3% | 96.6% |
| SWE-bench Verified | 修复真实软件项目的漏洞 | 49.2% | 48.9% |
| GPQA Diamond | 研究生水平的科学题 | 71.5% | 75.7% |
| SimpleQA | 简单事实问答 | 30.1% | 47.0% |
大致可以这样理解:在数学和编程上两者相当,在科学知识和事实问答上 o1 更好。
为什么震动了市场
真正让 R1 成为大新闻的,不只是分数,而是「便宜」。
R1 发布前一个月,DeepSeek 发布了 V3 基础模型,并称其训练成本只有约 560 万美元(指最后一轮训练所用的算力费用)。据维基百科整理的资料,DeepSeek 称 V3 用了约 2000 块英伟达 H800 芯片、训练约 55 天;而全球领先的 AI 公司训练模型时,使用的芯片多达 1.6 万块。OpenAI 首席执行官奥尔特曼曾在 2023 年说,训练基础模型的花费「远超」1 亿美元。
R1 在 V3 之上再训练。2025 年 9 月,DeepSeek 在经过同行评审、发表于《自然》(Nature)的论文中首次给出 R1 自己的数字:
- R1 训练成本(美元,不含 V3)
- 29.4 万
- 使用的 H800 芯片
- 512 块
- R1 训练时长
- 80 小时
- V3 自报训练成本(美元)
- 约 560 万
来源:路透社 2025-09-18 报道 DeepSeek 发表于《自然》的论文;V3 数字为 DeepSeek 2024 年底自报。
市场的逻辑是:如果用少得多的芯片就能做出同等水平的模型,那么各家公司计划中的巨额芯片和数据中心投资是否还有必要?
- 11 月 20 日R1 发布,模型权重以 MIT 许可证公开,DeepSeek 应用和网页版可免费使用。
- 21 月 27 日(周一)DeepSeek 应用超过 ChatGPT,成为美国 App Store 免费应用下载第一。
- 3同一天据路透社,英伟达股价下跌近 17%,市值蒸发约 5930 亿美元,是华尔街单只股票单日市值损失的纪录;纳斯达克指数跌 3.1%。
- 4同一天DeepSeek 称遭到「大规模恶意」网络攻击,暂时限制新用户注册。
来源:路透社、法新社 2025 年 1 月 27–28 日报道
(关于市值损失的数字,路透社按 LSEG 数据报道为约 5930 亿美元,法新社报道为约 5890 亿美元。)更完整的经过见本站《DeepSeek 登顶应用商店,英伟达单日蒸发约 5900 亿美元》。
据维基百科整理,美国总统特朗普称 DeepSeek 是一次「警醒」,微软首席执行官纳德拉和 OpenAI 的奥尔特曼都称它「非常令人印象深刻」;也有人表示怀疑,例如 Scale AI 首席执行官汪滔猜测中国拥有的英伟达 H100 芯片比外界以为的多。
需要注意的地方
- 分数是 DeepSeek 自己公布的。 上面的对比表全部来自 DeepSeek 的模型说明,测试条件由 DeepSeek 设定。
- 「训练成本」的口径很窄。 29.4 万美元只是 R1 在 V3 之上额外训练的费用;V3 的 560 万美元也只算最后一轮训练的算力,不含研发人员、前期实验和购买芯片的费用。据 The Decoder 报道,外界对 V3 真实总成本的估计从几千万到几亿美元不等。
- 芯片来源有争议。 据路透社报道,美国官员称 DeepSeek 拥有大量出口管制实施后获得的 H100 芯片;英伟达则称 DeepSeek 使用的是合法获得的 H800。DeepSeek 在《自然》论文的补充材料中首次承认拥有 A100 芯片,并在前期准备阶段用过它们。
- 「蒸馏」指控。 OpenAI 称 DeepSeek 可能「不当」使用了其模型的输出作训练数据(目前没有办法确证)。DeepSeek 在《自然》论文中表示,V3 的训练数据来自网络爬取的网页,其中包含「大量 OpenAI 模型生成的回答」,可能使模型间接学到其他强大模型的知识。2026 年 2 月,Anthropic 也指控 DeepSeek 用数千个虚假账号与 Claude 生成数百万段对话来训练自己的模型。
- 内容审查与隐私。 官方应用和 API 在中国大陆的服务器上运行,会对政治敏感话题进行审查;意大利、韩国、澳大利亚等多国监管机构对其数据收集提出过调查或限制。
对普通人意味着什么
- 免费用上「会思考」的模型。 R1 发布时,用户在 DeepSeek 网页和应用里打开「深度思考」就能免费使用它。现在 DeepSeek 的产品已更新到 V4 系列,见本站 DeepSeek 产品页和《DeepSeek V4》。
- 能在自己的设备上运行。 开源权重意味着企业可以把模型部署在自己的服务器上,数据不出门;蒸馏出的小模型(最小只有 15 亿参数)需要的算力要少得多。
- 价格压力。 R1 发布时的 API 价格为每百万 token 输入 0.55 美元(命中缓存为 0.14 美元)、输出 2.19 美元。据《财富》分析,DeepSeek 的开源路线带动了更多中国实验室发布开源模型,连 OpenAI 后来也发布了自己的开源权重模型 gpt-oss。
模型摘要
- 开发方
- DeepSeek
- 获取方式
- 开源权重(MIT 许可证);DeepSeek 应用与 API
- 规格
- 总参数 6710 亿,激活参数 370 亿(混合专家架构)
公布的评测成绩
| AIME 2024 (pass@1) | 79.8% | OpenAI o1:79.2% |
| MATH-500 (pass@1) | 97.3% | OpenAI o1:96.4% |
数据口径:DeepSeek 官方模型说明。评测成绩为厂商发布时公布的数据,各家测试条件不尽相同,横向比较需谨慎。